标签: 中文乱码

  • python3 requests解决中文乱码问题的几种方法

    python3 requests解决中文乱码问题的几种方法

    有三种方法解决请求后乱码问题。

    方法一:获取二进制数据,再利用str进行编码转换

    import requests
    url='http://music.baidu.com'
    r = requests.get(url)
    html=r.content
    html_doc=str(html,'utf-8') #html_doc=html.decode("utf-8","ignore")
    print(html_doc)

    方法二:使用r.text

    Requests 会自动解码来自服务器的内容。大多数 unicode 字符集都能被无缝地解码。请求发出后,Requests 会基于 HTTP 头部对响应的编码作出有根据的推测。当你访问 r.text 之时,Requests 会使用其推测的文本编码。你可以找出 Requests 使用了什么编码,并且能够使用 r.encoding 属性来改变它.
    但是Requests库的自身编码为: r.encoding = ‘ISO-8859-1’
    可以 r.encoding 修改编码

    import requests
    url='http://music.baidu.com'
    r=requests.get(url)
    r.encoding='utf-8'
    print(r.text)

    方法三:apparent_encoding获取网页编码

    上面的两个方法,适用于网页编码是utf-8的情况,但如果网页的默认编码不是utf-8,那么在设置编码的话就无从下手的,毕竟编码的类型那么多。这样可以使用 apparent_encoding获取网页使用的编码,在进行设置,如下:

    import requests
    url='http://laoji.org'
    r=requests.get(url)
    print(r.apparent_encoding)
    r.encoding=r.apparent_encoding
    print(r.text)
  • Linux 系统中 rrdtool 生成的图出现中文乱码(方块中带数字) 解决办法 图文教程

    Linux 系统中 rrdtool 生成的图出现中文乱码(方块中带数字) 解决办法 图文教程

    问题描述

    最近在帮公司迁移python的系统时出现了rrdtool绘图中无法显示中文的问题,如下图所示:

    查了很久的资料发现基本上说的都是cacti的中文乱码。但是在cacti里,绘出来的图中文是可以正常显示的。后来我们又手动编译安装了几次rrdtool包括后来换了几次版本。但是都不能解决中文的问题。这里就不详细说明。下面我们具体说一下我们的排查步骤。

    问题排查步骤

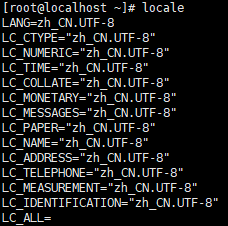
    locale 命令确认终端环境已支持中文

    rrdtool命令行直接生成图片,查看是否有中文乱码

    为了确认不是python程序的问题,我们直接使用终端rrdtool命令生成图图片,命令如下:

    rrdtool graph test.png --imgformat=PNG --start=1591259400 --end=1591295400 --title='SH-05-G06-H5720-Core - 流量 - Eth-Trunk2 - (to guipinglu_H6810)' --base=1000 --height=120 --width=500 --alt-autoscale-max --lower-limit=0 COMMENT:"从 2020/06/04 16\:30\:00 到 2020/06/05 02\:30\:00\c" COMMENT:"  \n" --vertical-label='bits per second' --slope-mode --font TITLE:10: --font AXIS:8: --font LEGEND:8: --font UNIT:8: DEF:a="/var/www/html/rra/940/33165.rrd":traffic_in:MAX DEF:b="/var/www/html/rra/940/33165.rrd":traffic_out:MAX DEF:c="/var/www/html/rra/940/33165.rrd":traffic_in:AVERAGE CDEF:cdefa=a,8,* CDEF:cdefe=b,8,* CDEF:cdefi=a,UN,INF,UNKN,IF AREA:cdefa#00CF00FF:"流入"  GPRINT:cdefa:LAST:"当前\:%8.2lf %s"  GPRINT:cdefa:AVERAGE:"平均\:%8.2lf %s"  GPRINT:cdefa:MAX:"最大\:%8.2lf %s\n"  LINE1:cdefe#002A97FF:"流出"  GPRINT:cdefe:LAST:"当前\:%8.2lf %s"  GPRINT:cdefe:AVERAGE:"平均\:%8.2lf %s"  GPRINT:cdefe:MAX:"最大\:%8.2lf %s\n"  AREA:cdefi#8F9286FF:"" 

    但是发现在终端中就已经无法正常显示中文了。基本可以确定是系统环境的问题。

    结论:没有中文字体原因导致

    后来无意中想到,也许是没有中文字体造成的。后来经过安装了字体之后就可以显示中文了。Centos7 安装中文字体 图文教程

  • Python3 Django 文件下载 中文文件名乱码 解决方案

    Python3 Django 文件下载 中文文件名乱码 解决方案

    本文记录一下在python3 django web开发中,下载文件时文件名为中文,出现乱码的解决方案。

    前端:

    <a href="/download/">下载</a>

    url.py:

    urlpatterns = [
        path('download/', download)
    ]

    views.py:

    from django.http import FileResponse
     
    def download(request):
        file = open('./static/download/简历.docx', 'rb')
        response = FileResponse(file)
        response['Content-Type'] = 'application/vnd.openxmlformats-officedocument.wordprocessingml.document'
        response['Content-Disposition'] = 'attachment;filename= '+'简历'.encode('utf-8').decode('ISO-8859-1')+'.docx'
        return response
    

    来解释一下download函数:

    1、首先是打开存放文件的目录,‘.’表示根目录,也就是你整个django项目的根目录。我的“简历.docx”文件就放在djangoProjectName/static/download/目录下。

    2、docx使用的MIME类型是 application/vnd.openxmlformats-officedocument.wordprocessingml.document。

    3、因为文件名中有中文,如果直接在Content-Disposition中包含中文会导致文件名无法正常显示,因此要以'简历'.encode('utf-8').decode('ISO-8859-1')的形式进行转码。

    网上搜到常用的有三种方法实现文件下载,我这边就试了这一种,其他你可以自己去搜一下然后试试。

  • php str_split函数字符串分割为数组 中文乱码解决方案

    php str_split函数字符串分割为数组 中文乱码解决方案

    str_split()这个函数;

    str_split() 函数把字符串分割到数组中。

    例如:

    $str='abcde';
    str_plite($str);

    打印结果如下:
    Array
    (
    [0] => a
    [1] => b
    [2] => c
    [3] => d
    [4] => e
    )

    看似很好用的样子;但是作为中国程序员。不可避免的要和中文打交道;

    这时候再用str_splite就会悲剧的发现乱码了,不要怕;preg_splite 可以拯救这个问题;

    当然是需要配合正则使用的;

    <?php
    /**
     * 将字符串分割为数组    
     * @param  string $str 字符串
     * @return array       分割得到的数组
     */
    function mb_str_split($str){
        return preg_split('/(?<!^)(?!$)/u', $str );
    }

    调用方法:

    <?php
    $str='老季博客';
    mb_str_split($str);
    打印结果如下:
    Array
    (
        [0] => 老
        [1] => 季
        [2] => 博
        [3] => 客
    )
WeChat