年度归档: 2019 年

  • Python 登录交换机switch 巡检 拉取交换机配置信息

    Python 登录交换机switch 巡检 拉取交换机配置信息

    场景需求

    前面老季写了一个 PHP如何登录连接TELNET并执行交换机命令类 图文教程 ,最近项目中遇到了要换python3来登录交换机并拉取配置。这里我们直接贴出相关代码使用telnetlib类来登录交换机并拉取配置。

    我们在代码中可以处理交换机拉取配置时,内容过长,出现 --- More --- 需要按空格的场景。并且将所有交换机命令的返回值都进行了返回给调用方法。

    代码实例

    class TelnetClient():
        def __init__(self,):
            self.tn = telnetlib.Telnet()
            time.sleep(0.2)
        # 此函数实现telnet登录主机
        def login(self,host_ip,username,password,port=23):
            try:
                # self.tn = telnetlib.Telnet(host_ip,port=23)
                self.tn.open(host_ip,port)
            except:
                logging.critical('网络连接失败'+repr(host_ip))
                return False
            # 等待login出现后输入用户名,最多等待10秒
            self.tn.read_until(b'Username: ',timeout=1)
            self.tn.write(username.encode('ascii') + b'\n')
            self.tn.read_until(b'Password: ',timeout=1)
            self.tn.write(password.encode('ascii') + b'\n')
            # 延时两秒再收取返回结果,给服务端足够响应时间
            time.sleep(0.2)
            # 获取登录结果
            # read_very_eager()获取到的是的是上次获取之后本次获取之前的所有输出
            command_result = self.tn.read_very_eager().decode('ascii')
            if 'Login incorrect' not in command_result:
                return True
            else:
                return False
        # 此函数实现执行传过来的命令,并输出其执行结果
        def execute_some_command(self,command):
            logging.info('开始执行交换机命令:'+command)
            # 执行命令
            self.tn.write(command.encode('ascii')+b'\n')
            time.sleep(0.2)
            # 获取命令结果
            a = []
            a.append(('--- More ---').encode('ascii'))
            command_result = self.tn.read_very_eager().decode('ascii')
            while True:
                b,c,d = self.tn.expect(a,timeout=1)
                command_result += d.decode('ascii')
                if 0 == b:
                    time.sleep(0.2)
                    self.tn.write(b' \n') #不用\r\n来继续
                else:
                    break
            logging.info('命令执行结果:'+repr(command_result))
            if 'Error:' in command_result :
                logging.critical('执行结果中可能包含错误`Error:`,脚本强制退出')
                sendWxMsg('流量调度系统交换机命令执行出现错误,请及时处理!')
                sys.exit()
            return command_result
        # 退出telnet
        def logout(self):
            self.tn.write(b"exit\n")
            self.tn.close()
    

    多个交换机命令时封装调用(可自行封装)

    # 执行多条交换机命令
    def execSwitchCmd( host , username , password , commands , extra = '1' ) :
        '''
        :param host:主机地址
        :param username:用户名
        :param password:密码
        :param commands:列表命令集
        :param extra: 是否需要执行 system-view , commit 命令
        '''
        logging.info('开始执行交换机命令【'+repr(commands)+'】')
        # return True
        telnet_client = TelnetClient()
        msg = ''
        # 如果登录结果返加True,则执行命令,然后退出
        if telnet_client.login(host,username,password) :
            if extra == 1:
                msg += telnet_client.execute_some_command( 'system-view' )
            for command in commands :
                msg += telnet_client.execute_some_command( command )
            if extra == 1:            
                msg += telnet_client.execute_some_command( 'commit' )
            telnet_client.logout()    
        return msg

    调用方法

    cmd = []
    cmd.append('dis traffic-policy applied-record TO_TrafficCenter')
    res = func.execSwitchCmd(room['host'],room['username'],room['password'],cmd , '0')
    if 'xxxxx' in res :
        # 某些配置在交换机中,做什么处理
        ......

    交换机命令过多时,建议使用\r\n拼接命令并分组

    def centerSchedulingOut95( destination_id , pieces ) :
        # .....
        #.......
        cmd = []
        i = 1
        divided = 12
        tmpCmd = ''
        for policy in policys :
            from_room = getRoomById( policy['destination_id'] )
            if i % divided == 0 :
                cmd.append( tmpCmd )
                tmpCmd = ''
            else :
                tmpCmd += '\r\n' + policy['name'] + '\r\n' + 'UNDO traffic-policy TO_'+from_room['abbr']+' inbound' + '\r\n' + 'traffic-policy TO_'+to_room['abbr']+' inbound' + '\r\n'
            i += 1
            config.cursor.execute("UPDATE center_policy SET status = 2 ,destination_id = %s , update_time=%s WHERE id = %s" , [ destination_id , getNow() , policy['id'] ] )
            logging.info('|----已更改 %s 状态为:使用中,去向机房ID:%s',policy['name'] , to_room['id'])
        if tmpCmd != '' :
            cmd.append( tmpCmd )
        logging.info('|----开始登录调度中心交换机,批量执行调出POLICY命令')
        config.cursor.execute("SELECT * FROM center")
        centerObj = config.cursor.fetchone()
        if len(cmd) > 0 :
            logging.info('|----本次实际调度POLICY规则条数:%s',repr( len(policys) ) )
            execSwitchCmd( host = centerObj['host'] , username = centerObj['username'] , password = centerObj['password'] , commands = cmd )

    我们这里将命令拼接成 \r\n的格式拼接,每12个命令一组,传入到交换机里执行。

  • Python3 半自动使用 ChromeDriver 采集豆瓣图片 并提交到 Chevereto 图床

    Python3 半自动使用 ChromeDriver 采集豆瓣图片 并提交到 Chevereto 图床

    前面我们写了Python 爬虫 抓取豆瓣小组图片 通过api提交入库到 Chevereto 图床,但是现在有些群组需要登录才行,所以我们这里做了一个半自动脚本并使用chromedriver自动登录豆瓣并提交图片到 Chevereto 图床。

    注:老季是Python新手,且本脚本大部分内容来自网络。

    chormedriver下载地址

    http://npm.taobao.org/mirrors/chromedriver/

    Python代码实例

    #!/usr/bin/python
    # -*- coding: UTF-8 -*-
    # 作者:老季
    # 网址:https://www.laoji.org
    #导入所需的库
    import logging
    import random
    import time
    import urllib.request
    import requests , json
    from selenium import webdriver
    # 实例化driver
    # option= webdriver.ChromeOptions()
    # driver = webdriver.Chrome(chrome_options=option)
    driver = webdriver.Chrome('D:\\Downloads\\chromedriver.exe') # chromedirver所在路径
    # 登陆
    driver.get('https://accounts.douban.com/passport/login')
    driver.find_element_by_class_name('account-tab-account').click()  # 模拟点击
    time.sleep(2)
    driver.find_element_by_id('username').send_keys('豆瓣用户名')  # 输入用户名
    driver.find_element_by_id('password').send_keys('豆瓣密码')  # 输入密码
    driver.find_element_by_css_selector("[class='btn btn-account btn-active']").click()  # 模拟点击
    time.sleep(5)
    '''
    TODO:验证码
    '''
    # 获取cookie
    session = requests.Session()
    cookies = driver.get_cookies()
    for cookie in cookies:
        session.cookies.set(cookie['name'], cookie['value'])
    # print(cookies)
    time.sleep(3)
    logging.FileHandler(filename='Selenium_img_douban.log', encoding='utf-8')
    logging.basicConfig(level=logging.INFO,
                        format='%(asctime)s %(filename)s[line:%(lineno)d] %(levelname)s %(message)s',
                        datefmt='%Y-%m-%d %A %H:%M:%S',
                        # filename='F:\\豆瓣下载\\Selenium_img_douban.log', # 日志保存路径
                        filemode='w')
    # 模拟浏览器提交图片
    def submit_img(url):
        submit_url = 'http://tutie.org/api/1/upload/?key='+urllib.parse.quote_plus('f14fe8e8b11c08902a489706d7d99941')+'&source='+urllib.parse.quote_plus(url)
    #    print(submit_url)
        req = urllib.request.Request(submit_url)
        try:
            res = urllib.request.urlopen(req)
            data = json.loads(res.read().decode())
            return str(data['status_code'])        
        except urllib.error.HTTPError as e:
            print(e.read())      
    
    def get_headers():
        '''
        随机获取一个headers
        '''
        user_agents = ['Mozilla/5.0 (Windows NT 6.1; rv:2.0.1) Gecko/20100101 Firefox/4.0.1',
                       'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-us) AppleWebKit/534.50 (KHTML, like Gecko) Version/5.1 Safari/534.50',
                       'Opera/9.80 (Windows NT 6.1; U; en) Presto/2.8.131 Version/11.11']
        headers = {'User-Agent': random.choice(user_agents)}
        return headers
    
    def get(url,group_url, start_page, end_page, params=None):
        '''
        向一个url发送get请求,返回response对象
        :param url: 网页链接
        :param params: URL参数字典
        :return: 发送请求后获取的response对象
        '''
        # 等待一个随机的时间,防止被封IP,这里随机等待0~6秒,亲测可有效地避免触发豆瓣的反爬虫机制
        time.sleep(6 * random.random())
        resp = session.get(url, params=params, headers=get_headers())
        print(resp)
        logging.info(resp)
        if resp:
            logging.info(
                '[get] url = {0}, status_code = {1}'.format(url, resp.status_code))
            resp.encoding = 'utf-8'
            # 这里很重要,每次发送请求后,都更新session的cookie,防止cookie过期
            if resp.cookies.get_dict():
                session.cookies.update(resp.cookies)
                logging.info('[get] updated cookies, new cookies = {0}'.format(
                    resp.cookies.get_dict()))
        else:
            logging.info('[get] url = {0}, response is None'.format(url))
        logging.info('[info] 寻找小组列表地址...')
        logging.info('[get] 已进入小组首页')
        while start_page <= end_page:
            driver.get(group_url + str((start_page - 1) * 25)) # 晒晒你最性感的照片小组
            logging.info('已进入第' + str(start_page) + '页')
            print('已进入第' + str(start_page) + '页')
            # 每一页讨论链接列表
            links = driver.find_elements_by_xpath(r"//tbody/tr/td[@class='title']/a")
            topic_links = {}
            for link in links:
                topic_link = link.get_attribute('href')
                title_name = link.get_attribute('title')
                # 获取的图片以小组话题名称命名
                img_name = title_name.replace('?', '?').replace('\\', '').replace('/', '').replace('"', '').replace(':','').replace('*','').replace('<', '').replace('>', '').replace('|', '').replace('\n', '')
                topic_links[topic_link] = img_name
                topic_num = 0
            for topic_link, img_name in topic_links.items():
                logging.info('进入第' + str(start_page) + '页,第' + str(topic_num + 1) + '话题。')
                topic_num += 1
                driver.get(topic_link)
                # 判断该话题下有无图片
                img_links = driver.find_elements_by_class_name('image-wrapper')
                if len(img_links) > 0:
                    i = 0
                    for img_link in img_links:
                        img_name = topic_links[topic_link] + '_' + str(i)
                        img_src = img_link.find_element_by_xpath('./img').get_attribute('src')
                        print('[get] 话题:' + img_name + ', 图片链接:' + img_src)
                        img = img_src.replace('.webp','.jpg')
                        print('提交图片链接:'+img)
                        submit_img( img )
                        # download_img = urllib.request.urlretrieve(img_src, 'F:\\豆瓣下载\\%s.jpg' % img_name)
                        # time.sleep(3 * random.random())
                        i += 1
                else:
                    print('该标题下无图片')
                img_links2 = driver.find_elements_by_css_selector("[class='topic-figure cc']")
                time.sleep(3 * random.random())
            start_page += 1
            time.sleep(3 * random.random())
        time.sleep(5)
        driver.quit()
    
    if __name__ == '__main__':
        home_url = 'https://www.douban.com/'
        group_url = 'https://www.douban.com/group/481977/discussion?start='
        get(home_url , group_url, 0, 10000)
    
  • Python3 Django admin后台中设置某个字段可以选择显示H5自定义颜色的选项卡

    Python3 Django admin后台中设置某个字段可以选择显示H5自定义颜色的选项卡

    场景需求

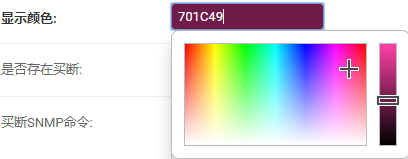
    在Django的项目开发中,如何在后台设置将某个字段使用H5的自定义颜色选择器,实现效果如下图所示:

    可以根据HTML5自定义颜色的设置自定义显示。

    这边我们记录一下如何才能实现

    安装Python扩展

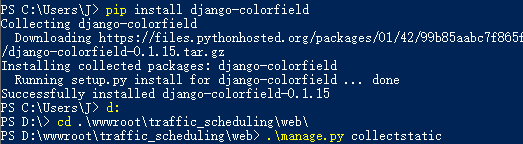
    在终端中执行如下命令

    pip install django-colorfield
    python .\manage.py collectstatic

    设置 settings.py

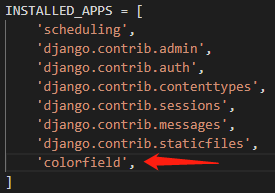
    打开 settings.py ,将 colorfield 添加到 INSTALLED_APPS 配置中

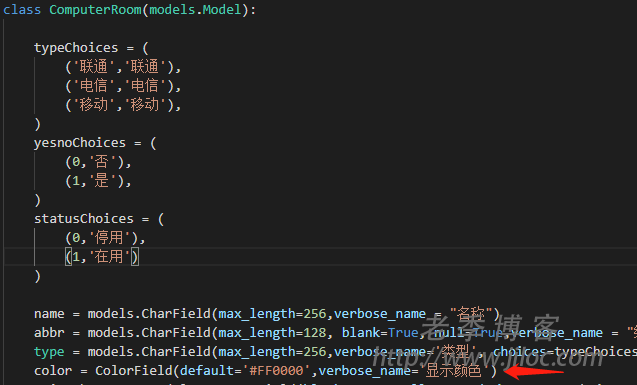
    models.py 中使用

    from django.db import models
    from colorfield.fields import ColorField
    class ComputerRoom(models.Model):
        name = models.CharField(max_length=256,verbose_name = "名称")
        abbr = models.CharField(max_length=128, blank=True, null=True,verbose_name = "缩写")
        type = models.CharField(max_length=256,verbose_name='类型', choices=typeChoices)
        color = ColorField(default='#FF0000',verbose_name='显示颜色')

    然后在Django后台打开对应的模块就可以看到颜色选择器了。

  • Python3 Django 框架中使用脚本预缓存多计算页面

    Python3 Django 框架中使用脚本预缓存多计算页面

    前面几篇文章我们讲述了

    由于我们的数据里已达到百万计,而且页面中有比较多的mysql跨库跨表的计算,在打开页面时会造成时间过长。所以我们需要在Django框架中如何对页面进行预缓存数据。

    本来我们打算使用 request 页面请求的方式,但是项目中需要登录以后才能看到这个页面,所以这条路不考虑。

    但是我们可以将预缓存的数据提前计算好放在Django的缓存中,然后在使用时显示出来。

    注:可以使用文件缓存的方式进行,然后看定期是否自动有新文件生成出来。

    代码实例

    #!/usr/bin/env python
    # coding: utf-8
    ######
    #  调用方法  python .\manage.py flushCaches
    ######
    from django.core.cache import cache
    from scheduling.views import getIndexResult
    import time , datetime , hashlib
    from django.core.management.base import BaseCommand, CommandError
    class Command(BaseCommand):
        def handle(self, *args, **options):
            date =  time.strftime("%Y-%m-%d %H:%M")
            print('开始预缓存首页数据,时间:%s'%date)
            cache_key = hashlib.md5(('index_'+date).encode(encoding='UTF-8')).hexdigest()
            if not cache.get(cache_key) :
                cache.get_or_set(cache_key, getIndexResult(date) ,60*60)

    调用方法

    python .\manage.py flushCaches

    crontab设置

    */1 * * * * cd /data/wwwroot/scheduling/web/ ; /usr/bin/python manage.py flushCaches >> /tmp/flushCache.log 2>&1

    下次我们打开页面时,速度就很快了。

  • Python3 Django框架中如何使用cache缓存代码实例

    Python3 Django框架中如何使用cache缓存代码实例

    场景描述

    在Django开发中,我们在 views.py 里用到了很多的sql查询,很多的跨表跨库显示,而且数据量已达到百万级,为了加快速度显示,这边启用了缓存。

    一开始我们想使用 @cache_page() 来达到缓存的目的,但是这样的缓存没有找到清除缓存的方法。

    所以我们只好使用cache的方式来缓存,这里用时间(年-月-日 时:分)md5后作为缓存的key。

    而且百度一下以后发现,关于django的cache讲述得很少。我们这里做一下简单的笔记。需要说明一下的是 cache.get_or_set ,我一开始以为是如果有这个值就自动获取,但是发现页面任然很慢。所以查了一下官方手册。 cache.get_or_set 手册里面写的是默认是设置新值。大家使用时一定要防止踩这个坑。

    cache.get_or_set(key, default, timeout=DEFAULT_TIMEOUT, version=None)

    If you want to get a key’s value or set a value if the key isn’t in the cache, there is the get_or_set() method. It takes the same parameters as get() but the default is set as the new cache value for that key, rather than simply returned:

    Python3 Django框架中的缓存机制

    views.py 代码实例

    from django.core.cache import cache
    @login_required
    def index( request ):
        if request.GET.get('date_joined_0') is None :
            lastDate = SnmpDiff.objects.values('update_time').filter( type = 'computer_room.snmp_95' ).order_by('-id')[1]
            date_joined_0 =  lastDate['update_time'].strftime("%Y-%m-%d")
            date_joined_1 =  lastDate['update_time'].strftime("%H:%M")
        else :
            date_joined_0 = request.GET.get('date_joined_0').replace('/','-')
            date_joined_1 = request.GET.get('date_joined_1')
        date = date_joined_0 + ' ' + date_joined_1
        cache_key = hashlib.md5(('index_'+date).encode(encoding='UTF-8')).hexdigest()
        # result = cache.get_or_set(cache_key, getIndexResult(date),60*60)
        if not cache.get(cache_key) :
            result = cache.get_or_set(cache_key, getIndexResult(date),60*60)
        else:
            result = cache.get(cache_key)

    现在除了第一次打开慢一点之外,其他时间打开飞快。

  • 腾讯云双十一优惠活动 云服务器年付88元 / 2核4G 5M带宽3年998元

    腾讯云双十一优惠活动 云服务器年付88元 / 2核4G 5M带宽3年998元

    时光飞逝,一晃又一年双十一即将到来,我们在感慨时间过的真快的时候,也看到各大电商平台憋足各种点子忽悠我们的钱包,又到一年购物季。对于我们大部分站长同学来说,肯定很多网友和LAOJI.ORG一样会较多的关注云服务器、云数据库、CDN流量包等等常用的云计算产品,毕竟在一年中虽然商家的活动也很多,但是双十一应该算是一年中活动最优惠,而且去年有些网友购买的产品可能也需要更换。

    在几个主流主机商中看到腾讯云商家率先发布双十一优惠提前购物活动,而且看到活动力度和以往还是有些区别的,这样难得他们会改变以往的一些依靠秒杀活动的陈旧策划。对于我们网友来说,在看到活动优惠力度的同时,好歹也需要看看活动策划是否新颖。

    腾讯云双十一提前购活动

    活动地址:访问腾讯云双十一提前购优惠活动

    目前已有的活动我们看到应该是腾讯云比较低的,但是后面在11月1日之后活动品类会有变化,配置可能会变化,但是同等配置的价格不会降低的。

    腾讯云双十一活动部分项目

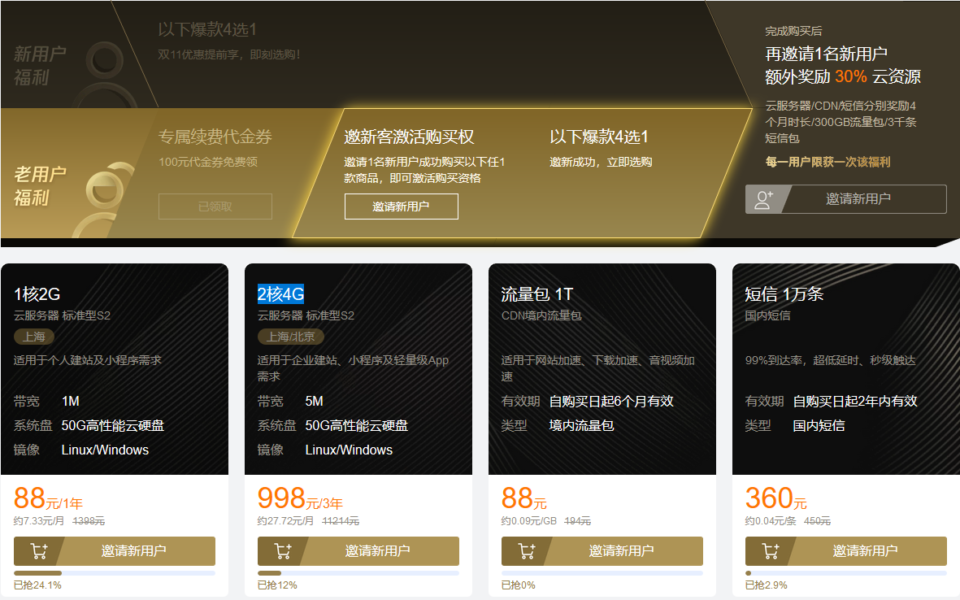
    腾讯云在策划上稍微用心一点,不是像之前秒杀活动方案用几年。我们可以看到老用户有100元代金券可以领取(满200元可用),四款特价产品(后续应该会变动),新用户可以直接购买享受优惠,如果是老用户则需要邀请有一个新用户购买之后也有资格购买。

    我们可以看到年付88元云服务器2GB内存方案适合入门练手,真做网站的话,老季建议选择2核心4GB内存5M带宽云服务器,记得之前活动是1440的,如今三年只需要998元。

  • 如何在Python3 Django 框架中执行自定义python脚本 图文教程

    如何在Python3 Django 框架中执行自定义python脚本 图文教程

    场景需求

    在Django项目开发中,调用一些底层的东西来跑脚本。

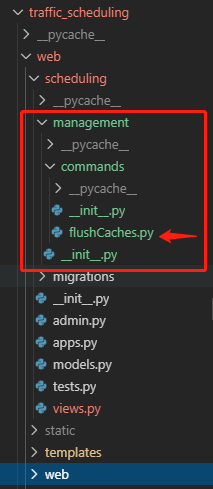
    目录结构

    django入门教程 创建项目(Project)和应用(App)

    这里需要自己新建目录,在应用目录中创建 management/commands 目录,我们这里将脚本名称命名为 flushCaches.py

    脚本代码实例

    #!/usr/bin/env python
    # coding: utf-8
    from django.core.management.base import BaseCommand, CommandError
    class Command(BaseCommand):
        def handle(self, *args, **options):
            # do something ....

    调用方法

    python .\manage.py flushCaches

  • python抓取网站提示错误ssl.SSLCertVerificationError处理

    python抓取网站提示错误ssl.SSLCertVerificationError处理

    问题描述

    python在抓取制定网站的错误提示:
    ssl.SSLCertVerificationError: [SSL: CERTIFICATE_VERIFY_FAILED] certificate verify failed: self signed certificate in certificate chain (_ssl.c:1056)

    解决方式

    在使用请求方法时添加一个参数verify = false就行了,如下:

    response = self.lagou_session.get(url=url,headers=self.header,verify=False)

    或

    res = requests.post(url, data = textmod,  headers = header_dict, verify=False)
  • Python 脚本递归删除 指定文件夹目录下 指定年份 删除所有文件

    Python 脚本递归删除 指定文件夹目录下 指定年份 删除所有文件

    场景需求

    服务器的磁盘被日志等一些老旧数据塞满了,如果人工删除的话需要很长时间。所以这边通过python脚本来做删除。

    本脚本需要在python3中运行。

    功能

    指定文件夹下递归删除所有修改日期在指定年份的文件。

    代码实例

    #!/usr/bin/env python
    # coding: utf-8
    import os , time , datetime , getopt ,sys
    def usage():
        print('usage:%s --input=[value] --output=[value] ')
        sys.exit()
    def listDir(fileDir,year):
         for eachFile in os.listdir(fileDir):
            if os.path.isfile(fileDir+"/"+eachFile):   #如果是文件,判断最后修改时间,符合条件进行删除
                ft = os.stat(fileDir+"/"+eachFile)
                ltime = time.localtime(int(ft.st_mtime)) #获取文件最后修改时间
                file_year = time.strftime("%Y",ltime)
                if int(file_year) == int(year) :         
                    print("删除文件: "+fileDir+"/"+eachFile)
                    # os.remove(fileDir+"/"+eachFile);   #删除文件
            elif os.path.isdir(fileDir+"/"+eachFile) :    #如果是文件夹,继续递归
                listDir(fileDir+"/"+eachFile , year)
    def del_emp_dir(path):
        for root, dirs, files in os.walk(path):
            if not os.listdir(root):
                try:
                    os.rmdir(root)
                except Exception as e:
                    pass
    if __name__ == '__main__':
        options, args = getopt.getopt(sys.argv[1:], '',['path=','year='])
        for name, value in options:
            if name in ('-p','--path'):
                path = format(value)
            elif name in ('-y','--year'):
                year = format(value)
        if 'path' not in locals().keys() or not 'year' in locals().keys() :
            usage()
        listDir(fileDir = path,year=year)
        del_emp_dir(path)
    

    调用方法

    python .\deleteFilesByYear.py --path="D:\Downloads\" --year=2019

  • linux下 设置 uwsgi 开机自启动

    linux下 设置 uwsgi 开机自启动

    前面我们写了Docker 下使用Centos系统镜像安装 uwsgi 运行 Python3 Django,但是重启docker以后容器中的uwsgi不能自动启动,所以我们这里来讲解一下如何另 uwsgi 开机自启动。

    终端进入Linux启动文件夹

    cd /etc/init.d

    在/etc/init.d/ 文件夹下创建一个shell脚本名为 uwsgi.sh 添加如下内容 :

    #!/bin/bash -e
    /usr/bin/uwsgi --ini /data/wwwroot/traffic_scheduling/web/uwsgi.ini

    修改uwsgi.sh的文件权限

    chmod 755 uwsgi.sh

    添加到开机自动启动

    update-rc.d uwsgi.sh defaults 99
  • Python3 Django框架中的缓存机制

    Python3 Django框架中的缓存机制

    概述:对于中等流量的网站来说,尽可能的减少开销是非常必要的。缓存数据就是为了保存那些需要很多计算资源的结果,这样的话就不必在下次重复消耗计算资源。获取数据的数据的时候就是去缓存中拿,拿到了直接返回,没拿到就去数据库中查询,筛选,然后缓存到数据库, 然后返回给模板。

    Django自带了一个健壮的缓存系统来保存动态页面,避免每次请求都重新计算。

    Django提供了不同级别的缓存策略,可以缓存特定的视图的输出、可以仅仅缓存那些很难计算出来的部分、或者缓存整个网站

    目的:优化数据结构;优化了对数据的查询;筛选,过滤;减少了对磁盘的IO

    官方文档:https://docs.djangoproject.co…

    设置缓存

    通过设置决定把数据缓存在哪里,是数据库中、文件系统中还是内存中

    默认缓存(内存)

    CACHES={
        'default':{
            'BACKEND':'django.core.cache.backends.locmem.LocMemCache',
            'LOCATION': 'unique-snowflake',
            'TIMEOUT':60
        }
    }

    参数TIMEOUT:缓存的默认过期时间,以秒为单位

    • 默认为300秒
    • 设置为None,表示永不过期
    • 设置为0造成缓存立即失效

    文件缓存

    CACHES = {
        'default': {
            'BACKEND': 'django.core.cache.backends.filebased.FileBasedCache',
            'LOCATION': 'c:/foo/bar',
            'TIMEOUT':300,
        }
    }

    数据库缓存

    CACHES = {
        'default': {
            'BACKEND': 'django.core.cache.backends.db.DatabaseCache',
            'LOCATION': 'my_cache_table',
            'TIMEOUT': '60',
            'KEY_PREFIX': 'bbs',
            'VERSION': '1',
            'OPTIONS': {
                'MAX_ENTRIES': '300'
            }
        }
    }

    创建缓存表: python manage.py createcachetable

    drf的缓存

    https://github.com/chibisov/drf-extensions

    这是drf的一个扩展,不止增强了缓存还有其他的。

    pip install drf-extensions
    

    缓存viewset中的retrieve和list 方法是很常见的。这就是为什么CacheResponseMixin存在。

    获取数据的才会用到cache

    from rest_framework_extensions.cache.mixins import CacheResponseMixin

    把这个CacheResponseMixin,放在list之前。尽量放在第一个继承的类

    class GoodsListViewSet(CacheResponseMixin,mixins.ListModelMixin, mixins.RetrieveModelMixin, viewsets.GenericViewSet):
    

    设置过期时间

    REST_FRAMEWORK_EXTENSIONS = {
        'DEFAULT_CACHE_RESPONSE_TIMEOUT': 5
    }
    

    根据自己需求加缓存。目前这个缓存使用的是内存。每次系统重启会丢失。

    redis缓存

    官网: http://django-redis-chs.readt…

    redis操作文档:http://redisdoc.com

    默认使用redis中的1数据库,但可以指定使用哪个db

    安装pip install django-redis

    配置

    # ---配置Session和Cache---
    CACHES={
        'default':{
            'BACKEND': 'django_redis.cache.RedisCache',
            'LOCATION':'127.0.0.1:6379/12', # 指定db12
            'TIMEOUT':60,
            'OPTIONS': {
                'CLIENT_CLASS': 'django_redis.client.DefaultClient',  # 指定连接Redis的客户端类
                # 'PASSWORD': 'mysecret',
                 # "SOCKET_CONNECT_TIMEOUT": 5,  # in seconds
                 # "SOCKET_TIMEOUT": 5,  # in seconds
                 # "CONNECTION_POOL_KWARGS": {"max_connections": 100},
                 # "CONNECTION_POOL_CLASS": "myproj.mypool.MyOwnPool",
            }
        }
    }
    SESSION_ENGINE = 'django.contrib.sessions.backends.cache'
    # --结束Session和Cache配置
    参数解释
    SOCKET_CONNECT_TIMEOUTsocket 建立连接超时设置
    SOCKET_TIMEOUT连接建立后的读写操作超时设置
    CONNECTION_POOL_KWARGS设置连接池的最大连接数量
    CONNECTION_POOL_CLASS自己的连接池子类

    连接池

    django-redis 使用 redis-py 的连接池接口, 并提供了简单的配置方式. 除此之外, 你可以为 backend 定制化连接池的产生。redis-py 默认不会关闭连接, 尽可能重用连接。

    连接池概念

    为什么使用连接池?首先Redis也是一种数据库,它基于C/S模式,因此如果需要使用必须建立连接,稍微熟悉网络的人应该都清楚地知道为什么需要建立连接,C/S模式本身就是一种远程通信的交互模式,因此Redis服务器可以单独作为一个数据库服务器来独立存在。假设Redis服务器与客户端分处在异地,虽然基于内存的Redis数据库有着超高的性能,但是底层的网络通信却占用了一次数据请求的大量时间,因为每次数据交互都需要先建立连接,假设一次数据交互总共用时30ms,超高性能的Redis数据库处理数据所花的时间可能不到1ms,也即是说前期的连接占用了29ms,连接池则可以实现在客户端建立多个链接并且不释放,当需要使用连接的时候通过一定的算法获取已经建立的连接,使用完了以后则还给连接池,这就免去了数据库连接所占用的时间。

    配置默认连接池

    配置默认连接池很简单, 你只需要在 CACHES 中使用 CONNECTION_POOL_KWARGS 设置连接池的最大连接数量即可

    你可以得知连接池已经打开多少连接:

    from django.core.cache import get_cache
    from django_redis import get_redis_connection
    r = get_redis_connection("default")  # Use the name you have defined for Redis in settings.CACHES
    connection_pool = r.connection_pool
    print("Created connections so far: %d" % connection_pool._created_connections)

    使用自己的连接池子类

    有时你想使用自己的连接池子类. django-redis 提供了 CONNECTION_POOL_CLASS 来配置连接池子类

    myproj/mypool.py

    from redis.connection import ConnectionPool
    class MyOwnPool(ConnectionPool):
        # Just doing nothing, only for example purpose
        pass

    缓存的用法

    单个view缓存

    django.views.decorators.cache.cache_page装饰器用于对视图 views.py 的输出进行缓存

    from django.views.decorators.cache import cache_page
    @cache_page(60 * 2)
    def index(request):
        # return HttpResponse("sunck is a good man")
        return HttpResponse("sunck is a nice man")
    参数:
    timeout : 有效时长  # we've written it as 60 * 15 for the purpose of readability
    cache: 缓存到哪一个库中;很少使用;针对于系统配置了多个缓存
           如: @cache_page(timeout=60, cache='filecache')
    key_prefix: 前缀      

    模板片段缓存

    cache标签: 参数

    • 缓存时间,以秒为单位
    • 给缓存片段起名字
    {#{% load static from staticfiles %}#}
    {% load static %}
    {% load cache %}
    <!DOCTYPE html>
    <html lang="en">
    <head>
        <meta charset="UTF-8">
        <title>主页</title>
    {#    <link rel="stylesheet" type="text/css" href="/static/css/index.css">#}
        <link rel="stylesheet" type="text/css" href="{% static 'css/index.css' %}">
    </head>
    <body>
        <h1>sunck is a nice man</h1>
        {% cache 120 sunck %}
            <h1>nice man</h1>
            <!--<h1>good man</h1>-->
        {% endcache %}
    </body>
    </html>

    原生cache

    from django.core.cache import cache
    查看所有缓存的key: cache.keys('*')
    设置:cache.set(键, 值, 有效时间)
    获取:cache.get(键)
    删除:cache.delete(键)
    清空:cache.clear()
    >>> cache.set_many({'a': 1, 'b': 2, 'c': 3})
    >>> cache.getmany(['a','b','c'])
    {'a': 1, 'b': 2, 'c': 3}
    cache.delete_pattern("foo_*") # 全局通配符
  • Python3 Django 后台列表 自定义修改单元格中字体颜色 图文教程

    Python3 Django 后台列表 自定义修改单元格中字体颜色 图文教程

    需求描述

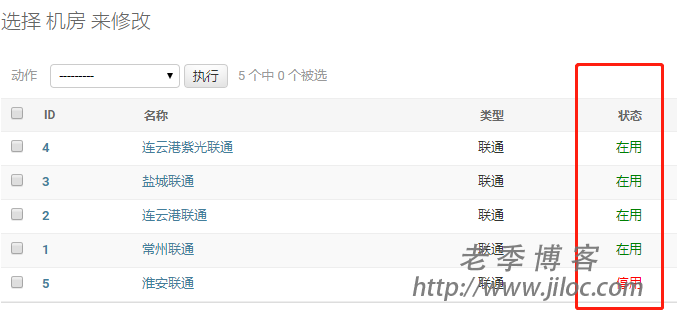
    在Django的后台实际开发过程中,我们直接建立模型后可以很快的生成一个列表。那么如何在后台list列表中自定义某个列的单元格中的字体颜色呢?效果如下图所示:

    代码实例

    在 admin.py 中自定义一个方法, statusColored :

    from scheduling import models
    from django.utils.html import format_html
    class ComputerRoomAdmin(admin.ModelAdmin):
        list_display = ('id', 'name','type','statusColored','weights')
        list_display_links = ('id','name')  
        ordering = ('-status','weights',)
        list_filter = ('type','status')
        def statusColored(self , obj):
            if obj.status == 0:
                return format_html('<span style="color:red">{}</span>','停用')
            else:
                return format_html('<span style="color:green">{}</span>','在用')
        statusColored.short_description = "状态"
    
    admin.site.register(models.ComputerRoom , ComputerRoomAdmin)

    models.py 模型中,我们的设置为 choices

        statusChoices = (
            (0,'停用'),
            (1,'在用')
        )
        status = models.IntegerField( choices=statusChoices,verbose_name='状态' , default=1 )

WeChat
↑